Học Máy Là Gì? Hướng Dẫn Dễ Hiểu Vượt Qua Cường Điệu
Khi các tiêu đề báo nói về những cỗ máy biết suy nghĩ, sáng tạo và thậm chí vượt qua con người, rất dễ đánh mất cái nhìn thực tế về công nghệ thực sự làm được gì. Nếu bạn đang tìm kiếm học máy là gì được giải thích bằng ngôn ngữ đơn giản, câu trả lời thực tế và ít bí ẩn hơn nhiều so với những gì khoa học viễn tưởng gợi ý. Dưới góc nhìn được chia sẻ bởi trường công nghệ, học máy không phải là phép màu hay ý thức nhân tạo. Đó là phương pháp giúp máy tính cải thiện khả năng thực hiện một nhiệm vụ bằng cách tìm ra các quy luật trong dữ liệu, thay vì chỉ tuân theo những chỉ dẫn tường minh do lập trình viên viết sẵn.
Học Máy Thực Chất Là Gì (Và Không Phải Là Gì)
Lập trình truyền thống hoạt động giống như một công thức nấu ăn: lập trình viên viết từng bước quy tắc, và máy tính tuân theo chính xác. Nếu bạn muốn lọc thư rác theo cách đó, bạn sẽ phải viết quy tắc cho mọi cụm từ rác có thể, mọi mánh khóe của người gửi và mọi kiểu định dạng lạ. Cách tiếp cận này nhanh chóng thất bại vì ngôn ngữ quá đa dạng.
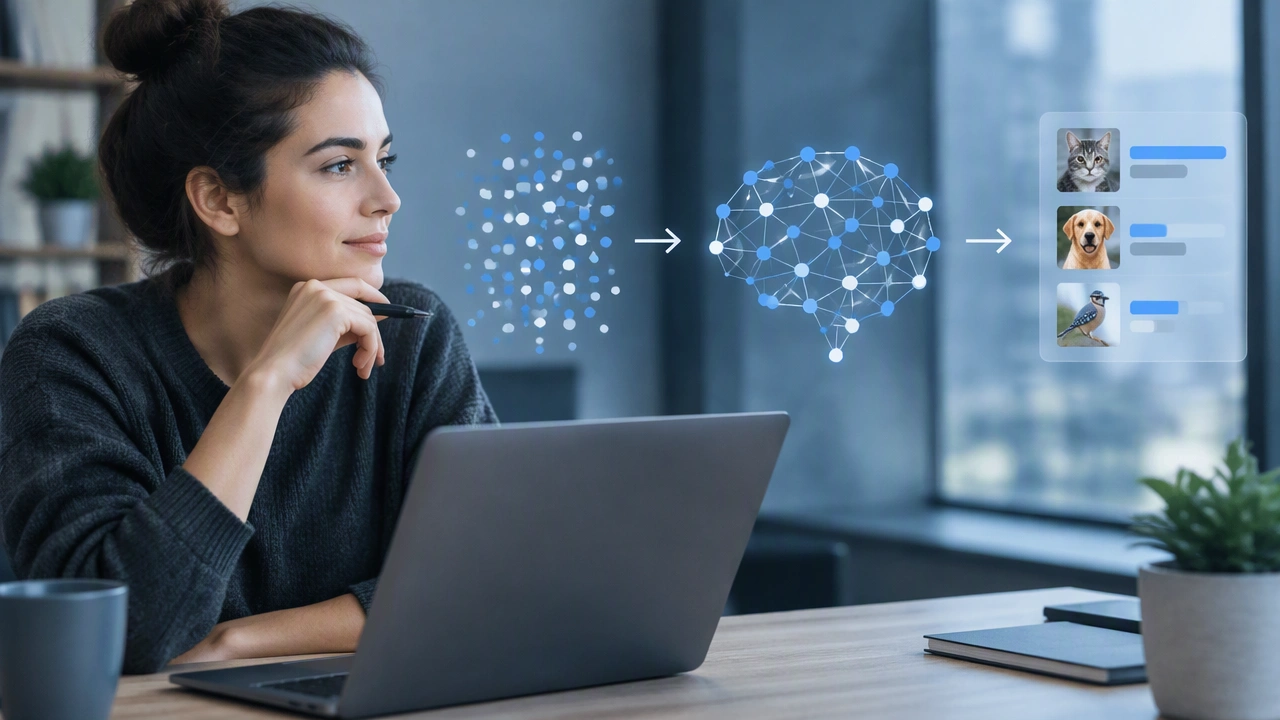
Học máy đảo ngược quy trình. Thay vì đưa cho máy tính mọi quy tắc, bạn cung cấp cho nó nhiều ví dụ và một mục tiêu chung. Với việc lọc thư rác, bạn cho nó xem hàng nghìn email đã được gắn nhãn là rác hoặc không rác. Hệ thống phân tích các ví dụ đó, tìm ra các quy luật thống kê phân biệt hai nhóm và xây dựng một mô hình có thể dự đoán cho những email mới chưa từng thấy. Mô hình không phải đang ghi nhớ; nó đang học một quy luật chung để có thể áp dụng.
- Nó là gì: Phần mềm cải thiện hiệu suất cho một nhiệm vụ cụ thể khi được tiếp xúc với nhiều dữ liệu liên quan hơn.
- Nó không phải là gì: Một chiếc máy tính hiểu được ý nghĩa, có tri thức thông thường hay có mong muốn. Nó không có ý định hay nhận thức.
- Ý tưởng cốt lõi: Lập trình viên xác định nhiệm vụ, dữ liệu và cách đo lường sự thành công. Thuật toán sẽ tự tìm ra những điều chỉnh nội bộ để đạt được mục tiêu.
Cách Học Máy Hoạt Động Theo Cách Đơn Giản
Bạn không cần toán học để hiểu quy trình cơ bản. Hầu hết các dự án học máy đều tuân theo ba giai đoạn giống nhau, dù là gợi ý phim hay phát hiện giao dịch gian lận.
1. Dữ Liệu Huấn Luyện Là Sách Giáo Khoa
Mọi thứ bắt đầu từ dữ liệu. Dữ liệu là tập hợp các ví dụ mà hệ thống học hỏi. Với mô hình nhận dạng hình ảnh, đó có thể là hàng triệu bức ảnh được gắn nhãn mèo hay chó. Với công cụ dịch thuật, đó là các cặp câu ở hai ngôn ngữ. Chất lượng và sự đa dạng của dữ liệu này quan trọng hơn hầu hết mọi yếu tố khác. Nếu sách giáo khoa không đầy đủ hoặc thiên lệch, mô hình sẽ học được một bài học không đầy đủ hoặc thiên lệch, dù thuật toán có tinh vi đến đâu.
2. Mô Hình Học Quy Luật, Không Phải Quy Tắc
Mô hình là cấu trúc toán học cố gắng ánh xạ đầu vào tới đầu ra. Trong quá trình huấn luyện, thuật toán đưa ra một phỏng đoán, kiểm tra xem phỏng đoán lệch bao xa so với đáp án đúng và điều chỉnh nhẹ các thiết lập nội bộ để làm tốt hơn ở lần sau. Chu kỳ này lặp lại hàng triệu lần. Hãy hình dung như việc tinh chỉnh các núm xoay cho đến khi hết nhiễu. Mô hình không được bảo rằng tai nhọn nghĩa là mèo; nó dần dần khám phá ra tổ hợp các mẫu điểm ảnh nào liên quan đáng tin cậy nhất với nhãn mèo trong dữ liệu nó đã thấy.
3. Dự Đoán và Vòng Lặp Phản Hồi
Sau khi được huấn luyện, mô hình được kiểm tra trên dữ liệu mới mà nó chưa từng thấy trước đó. Đây là cách chúng ta biết liệu nó thực sự đã học được một quy luật chung hay chỉ ghi nhớ sách giáo khoa. Nếu hoạt động tốt, nó có thể được triển khai để đưa ra dự đoán trên dữ liệu thực tế. Trên thực tế, các hệ thống tốt vẫn tiếp tục học hỏi. Khi người dùng đánh dấu một dự đoán thư rác là sai, phản hồi đó có thể trở thành dữ liệu huấn luyện mới để phiên bản tiếp theo chính xác hơn.
Các Loại Học Máy Chính Bạn Sẽ Gặp
Mọi người thường chia học máy thành một vài nhóm lớn dựa trên loại dữ liệu và phản hồi được sử dụng.
Học Có Giám Sát
Đây là loại phổ biến nhất. Bạn huấn luyện mô hình bằng các ví dụ đã được gán nhãn, nơi đáp án đúng đã được biết trước. Mô hình học cách dự đoán nhãn cho dữ liệu mới. Ví dụ bao gồm dự đoán giá nhà dựa trên diện tích và vị trí, phân loại email rác, hoặc chuyển giọng nói thành văn bản. Nó được gọi là có giám sát vì con người đã cung cấp đáp án đúng trong quá trình huấn luyện.
Học Không Giám Sát
Ở đây dữ liệu không có nhãn. Mục tiêu là tự tìm ra cấu trúc ẩn. Ví dụ, một công ty thương mại điện tử có thể dùng học không giám sát để nhóm khách hàng thành các phân khúc dựa trên hành vi mua sắm, mà không cần báo trước cho hệ thống các phân khúc đó nên là gì. Nó hữu ích cho việc khám phá, phát hiện bất thường và sắp xếp các tập dữ liệu lớn, lộn xộn.
Học Tăng Cường
Trong cách tiếp cận này, một tác nhân học bằng cách thử và sai trong một môi trường, nhận phần thưởng cho hành động tốt và hình phạt cho hành động xấu. Đó là cách hệ thống học chơi trò chơi hoặc robot học cách di chuyển. Mô hình không được chỉ cho đáp án đúng; nó phải tự thử nghiệm để khám phá chiến lược tối đa hóa phần thưởng theo thời gian.
Nơi Bạn Đã Sử Dụng Học Máy Mỗi Ngày
Học máy nghe có vẻ tương lai, nhưng bạn có thể tương tác với nó nhiều lần mỗi ngày mà không nhận ra. Trong hầu hết trường hợp, nó đang thực hiện một nhiệm vụ hẹp và được xác định rõ:
- Tìm kiếm và gợi ý: Công cụ tìm kiếm xếp hạng kết quả, dịch vụ phát trực tuyến gợi ý nội dung xem tiếp theo và cửa hàng trực tuyến đề xuất sản phẩm dựa trên lịch sử duyệt web của bạn.
- Giao ti���p: Bộ lọc thư rác, tự động sửa lỗi và gợi ý văn bản, trợ lý giọng nói chuyển giọng nói thành văn bản và dịch tự động.
- Thị giác và điều hướng: Mở khóa bằng khuôn mặt trên điện thoại, ứng dụng ảnh nhóm hình theo người và bản đồ dự đoán tình hình giao thông và ước tính thời gian đến nơi.
- An toàn và tài chính: Ngân hàng gắn cờ các giao dịch bất thường có thể là gian lận và nhà cung cấp email phát hiện các nỗ lực lừa đảo.
Hãy chú ý quy luật: mỗi hệ thống chỉ làm một việc cụ thể, và nó thực hiện bằng cách nhận diện các quy luật trong lượng lớn dữ liệu lịch sử.
Học Máy Không Làm Được Gì: Kiểm Chứng Cường Điệu
Việc tách biệt khả năng thực sự khỏi cường điệu kiểu khoa học viễn tưởng là điều cần thiết để hiểu công nghệ. Dưới đây là những hiểu lầm phổ biến nhất.
- Nó không thực sự hiểu. Chatbot có thể tạo ra câu trôi chảy vì nó đã học các quy luật thống kê trong ngôn ngữ, chứ không phải vì nó hiểu ý nghĩa như con người. Nó có thể nói rất tự tin dù hoàn toàn sai.
- Nó không mặc định khách quan. Mô hình phản ánh dữ liệu mà nó được huấn luyện. Nếu dữ liệu đó ch��a định kiến lịch sử, sai số đo lường hoặc khoảng trống, mô hình sẽ tái tạo và thậm chí khuếch đại chúng.
- Nó không thể suy luận ngoài phạm vi huấn luyện. Mô hình được huấn luyện để chẩn đoán bệnh da liễu từ hình ảnh không thể đột nhiên chẩn đoán lỗi động cơ. Nó không có tri thức thông thường tổng quát và gặp khó khăn với những tình huống rất khác so với dữ liệu huấn luyện.
- Nó cần nhiều dữ liệu và sự giám sát của con người. Học máy không tạo ra tri thức từ hư không. Nó đòi hỏi dữ liệu được thu thập cẩn thận, đánh giá rõ ràng và sự kiểm tra liên tục của con người để duy trì độ chính xác và an toàn.
Học Máy vs. Trí Tuệ Nhân Tạo vs. Học Sâu
Những thuật ngữ này thường được dùng thay thế cho nhau, nhưng chúng không giống nhau. Trí tuệ nhân tạo là thuật ngữ bao quát nhất: bất kỳ kỹ thuật nào cho phép máy tính thực hiện các nhiệm vụ vốn thường cần trí thông minh của con người. Học máy là một nhánh của trí tuệ nhân tạo: một cách tiếp cận cụ thể nơi hệ thống học từ dữ liệu. Học sâu là một nhánh của học máy sử dụng mạng nơ-ron nhiều lớp lấy cảm hứng từ cách các nơ-ron kết nối với nhau. Học sâu đặc biệt giỏi với dữ liệu phức tạp như hình ảnh, âm thanh và ngôn ngữ tự nhiên, đó là lý do nó thúc đẩy nhiều tiến bộ gần đây, nhưng nó cũng đòi hỏi nhiều dữ liệu và sức mạnh tính toán hơn so với các phương pháp học máy đơn giản hơn.
Cách Bắt Đầu Hiểu Học Máy Mà Không Cần Lập Trình
Bạn không cần trở thành lập trình viên để có được hình dung thực tế về cách nó hoạt động. Hãy tập trung vào các khái niệm đằng sau công cụ.
- Hãy nghĩ theo đầu vào và đầu ra. Với bất kỳ sản phẩm học máy nào, hãy hỏi: Dữ liệu nào được đưa vào, dự đoán nào được đưa ra và sự thành công được đo lường như thế nào?
- Đặt câu hỏi về dữ liệu. Dữ liệu huấn luyện đến từ đâu, ai đã gán nhãn và điều gì có thể bị thiếu hoặc bị đại diện quá mức?
- Tìm kiếm các nhiệm vụ hẹp. Hãy hoài nghi trước những tuyên bố rằng một hệ thống duy nhất có thể làm mọi thứ. Học máy hữu ích hiện nay hầu như luôn hẹp và chuyên biệt cho từng nhiệm vụ.
- Thử thách giới hạn. Hãy thử đưa cho hệ thống một đầu vào bất thường hoặc ở trường hợp biên. Cách nó thất bại sẽ cho bạn biết nhiều điều về những gì nó thực sự đã học.
Học máy là một công cụ mạnh mẽ để tìm ra các quy luật hữu ích ở quy mô mà không con người nào có thể xử lý thủ công. Nó có thể tự động hóa các quyết định thường nhật, làm nổi bật những hiểu biết sâu sắc trong dữ liệu phức tạp và làm cho nhiều sản phẩm hàng ngày trở nên hữu ích hơn. Tuy nhiên, nó không mang lại cho máy tính niềm tin, mục tiêu hay sự thấu hiểu. Khi bạn thấy một tuyên bố mới về khả năng của AI, câu hỏi hữu ích nhất không phải là liệu cỗ máy có thông minh hay không, mà là liệu nó đã được cho xem đủ lượng dữ liệu phù hợp để thực hiện một cách đáng tin cậy nhiệm vụ cụ thể đó hay chưa.